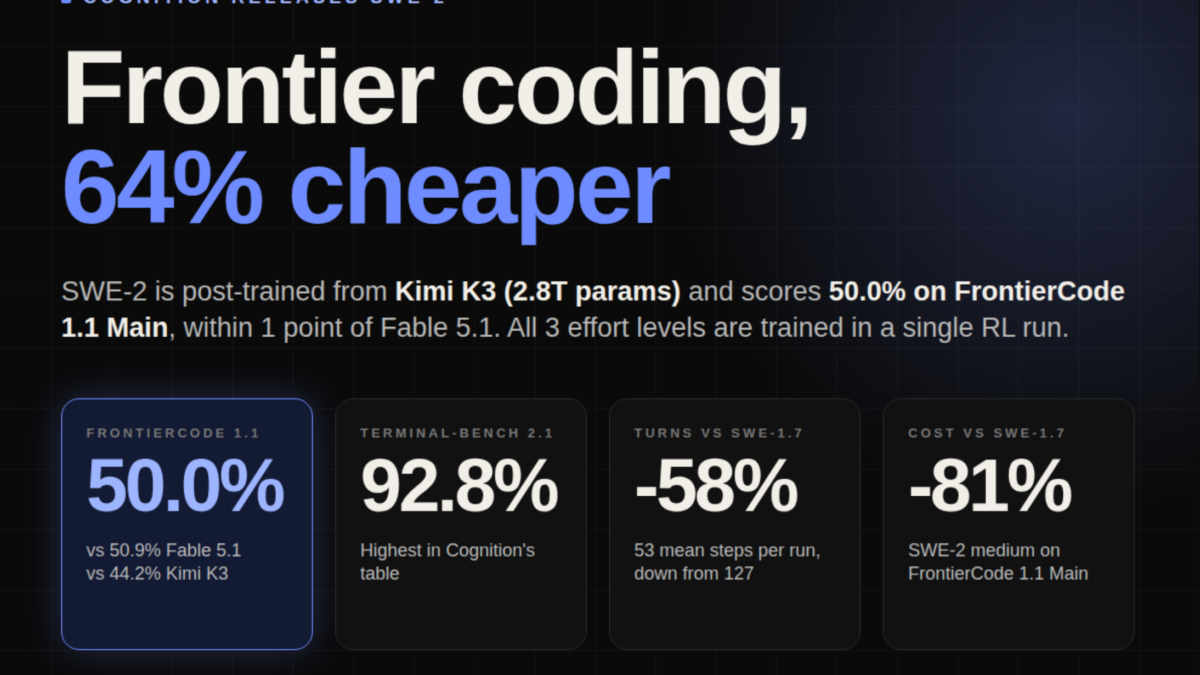
¡Atención, desarrolladores y entusiastas de la IA! Cognition, la mente detrás del agente de codificación Devin, acaba de dar un golpe sobre la mesa con el lanzamiento de SWE-2. Este nuevo modelo de lenguaje grande (LLM) para tareas de programación no solo promete igualar el rendimiento de pesos pesados como Fable 5.1, sino que lo hace a un costo significativamente menor, un 64% menos según sus propios benchmarks. Esto es música para los oídos de cualquiera que busque optimizar recursos sin sacrificar calidad.
Un Salto Cuántico en Eficiencia y Rendimiento
SWE-2 se basa en la infraestructura de su predecesor, SWE-1.7, pero con una mejora sustancial: ha sido entrenado con el modelo Kimi K3 de Moonshot AI, que cuenta con la friolera de 2.8 billones de parámetros. Cognition ha aplicado técnicas de aprendizaje por refuerzo (RL) para afinar aún más este gigante, logrando una puntuación del 50.0% en FrontierCode 1.1 Main, apenas un punto por debajo de Fable 5.1. Lo más interesante es que SWE-2 introduce niveles de ‘esfuerzo de razonamiento’ seleccionables, todos entrenados en una sola pasada de RL. Esto significa que podemos ajustar la IA para que sea más rápida y barata en tareas sencillas, o más exhaustiva y precisa en las complejas, sin necesidad de reentrenamientos costosos.
¿Listo para Desplegar? La Letra Pequeña Importa
Aquí es donde la cosa se pone interesante para los que pensaban en integrar SWE-2 en sus propias infraestructuras. La respuesta corta es: no. SWE-2 no es un modelo de código abierto con pesos disponibles ni una API independiente. Su despliegue está, por ahora, estrictamente ligado al ecosistema de Devin: Desktop y CLI, con Devin Web y Fusion en camino. Esto limita su accesibilidad directa, pero lo convierte en una herramienta potentísima dentro de la suite de Cognition. En términos de rendimiento, SWE-2 brilla en benchmarks como Terminal-Bench 2.1, superando a su modelo base K3 en todas las filas. Sin embargo, no todo es perfecto: muestra debilidades notables en Terminal-Bench 4, donde queda rezagado frente a Fable 5.1 y GPT-6 Astra.
Menos Rodeos, Más Código: La Evolución del Comportamiento
Una de las mejoras más destacadas de SWE-2 es su capacidad para reducir las ‘vueltas’ innecesarias en tareas simples. Gracias a lo que Cognition llama ‘exploración enfocada’, SWE-2 medium, por ejemplo, logra puntuaciones más altas en FrontierCode 1.1 Main con un 58% menos de pasos y un costo un 81% menor en comparación con SWE-1.7. Esto se traduce en un flujo de trabajo más ágil y eficiente. Además, el modelo demuestra una mayor cobertura de pruebas de extremo a extremo, ingenio para sortear herramientas bloqueadas y una disciplina de verificación rigurosa, re-derivando conclusiones en lugar de simplemente reafirmarlas cuando se le cuestiona.
Detrás de Escena: La Receta del Éxito
El entrenamiento de SWE-2 es una obra de ingeniería. Utiliza penalizaciones de costo informadas por Pareto, donde la recompensa se ajusta según el éxito y el costo (inferencia y tiempo de ejecución). La clave está en que cada nivel de esfuerzo tiene su propia penalización, moviendo la frontera de costo-rendimiento de forma conjunta. También emplean una línea base de recompensa ponderada por longitud, lo que estabiliza el entrenamiento sin aumentar el cómputo. Para optimizar la inferencia, recurren a técnicas como el prefill delayer y el decodificado especulativo con DSpark, además de kernels NVFP4 y FP8 con entrenamiento consciente de la cuantización para mantener el uso de memoria bajo control. El conjunto de datos también se ha triplicado, incorporando entornos de RL, superposiciones de seguimiento de instrucciones y un sistema que utiliza puntos de control anteriores para corregir errores.
Confiabilidad a Prueba: ¿Qué Tan Seguro es?
Cognition ha puesto a prueba la confiabilidad de SWE-2, especialmente en temas sensibles. En un conjunto de 145 preguntas políticamente sensibles sobre China, SWE-2 aprobó el 98.0% en general, con un rendimiento excelente en inglés y chino. En pruebas de vulnerabilidad dependientes del contexto, el modelo no mostró cambios estadísticamente significativos en su comportamiento ante diferentes enfoques. Si bien la falta de acceso abierto y API puede ser un freno para algunos, el avance en eficiencia y rendimiento de SWE-2 lo posiciona como un jugador clave en el futuro de la codificación asistida por IA, siempre y cuando se opere dentro de su ecosistema.