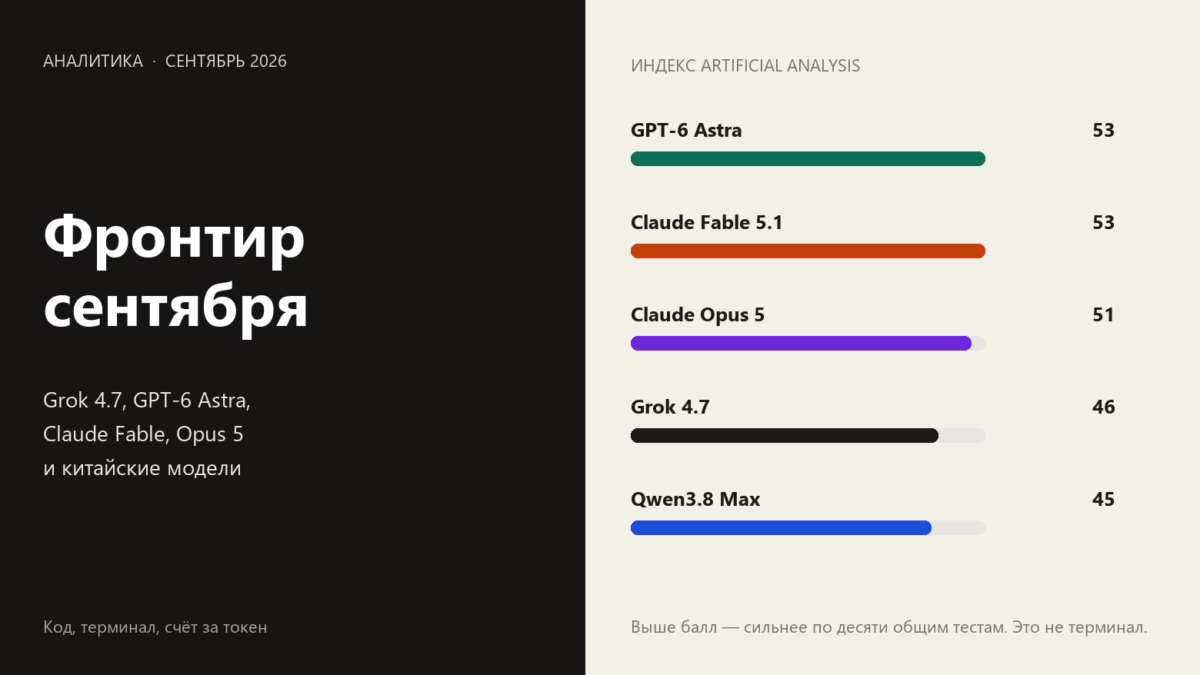
El panorama de la inteligencia artificial está viviendo un terremoto geopolítico silencioso. Mientras Occidente celebraba los lanzamientos de Grok 4.7, GPT-6 Astra y Claude Fable 5.1, los laboratorios chinos han ejecutado un movimiento estratégico que redefine las reglas del juego. Ya no son el “aeropuerto de reserva barato” del que hablaban los analistas hace un año. Hoy, modelos como Qwen3.8 Max de Alibaba se paran hombro con hombro con Grok de SpaceXAI, ofreciendo el mismo precio de 2 y 6 dólares por millón de tokens y separándose por apenas un punto en el índice general de Artificial Analysis.
El tablero de rendimiento: donde las cifras cuentan otra historia
El índice v4.3.2 de Artificial Analysis, que evalúa diez dimensiones desde tareas de oficina hasta automatización de interfaces, muestra un panorama fragmentado. Los siete puntos que separan a Astra (53) de Grok 4.7 (46) no son una diferencia cosmética: marcan la frontera entre el primer y segundo escalón. Sin embargo, aquí aparece la sorpresa china: Qwen3.8 Max alcanza 45 puntos, Kimi K3 llega a 44 y DeepSeek V4 Flash se posiciona en 35. Pero estas cifras generales esconden fortalezas específicas que están redefiniendo nichos completos del mercado.
En Terminal-Bench 4.0, la prueba más exigente de trabajo en terminal real, las diferencias se amplifican. Mientras Grok 4.7 muestra un 38% en su propia plataforma Grok Build, en las pruebas independientes de Artificial Analysis cae al 26%. Aquí, DeepSeek V4 Flash, con su licencia MIT y precios que bajan a 0,22 dólares fuera de pico, supera por un punto porcentual al modelo de SpaceXAI. “La diferencia entre el 38% en la ficha de Grok y el 26% en pruebas ajenas ya no son décimas”, señala el análisis técnico.
Fortalezas ocultas y nichos conquistados
Donde los modelos chinos están reescribiendo las reglas es en dominios especializados. En FrontierSWE V2, que evalúa 34 tareas de hasta 20 horas de duración, Kimi K3 alcanza un 25,9%, posicionándose cerca del 29% de Grok 4.7. “Para tareas de contexto largo donde entra una imagen, tiene sentido ponerla primera entre las chinas en tu prueba”, recomiendan los analistas. GLM-5.3 de Z.ai, por su parte, muestra su mayor fortaleza en ingeniería de larga duración, mientras que su versión Flash se ubica entre los mejores modelos de pesos abiertos con 42 puntos.
El caso más emblemático es el jurídico. En pruebas de Vals AI con 120 casos cerrados y criterios de aprobación estrictos, Grok 4.7 lidera con 19,6%, seguido por su versión anterior con 15,8%. Fable 5.1 apenas alcanza 6,7%. “La ventaja de Grok no es cosmética”, destacan los evaluadores. En EEBench, que mide esquemas y chips electrónicos, Grok se ubica entre Astra (69,3%) y Opus (61,6%) con un 66%, mostrando fortalezas en dominios técnicos específicos que los índices generales ocultan.
La ecuación costo-rendimiento: el nuevo campo de batalla
El gráfico más revelador coloca a Qwen y Grok en el mismo punto de precio (2/6 dólares) y rendimiento (45 vs 46 puntos). DeepSeek V4 Flash, aunque con menor puntuación general (35), ofrece una relación precio-rendimiento disruptiva: 0,44/1,32 dólares en pico y la mitad fuera de él, con velocidad de 200 tokens por segundo. “Hace un año, comparar con DeepSeek era hablar de ‘diez veces más barato y notablemente peor’. En septiembre de 2026 la formulación es otra”, admiten los analistas.
La sofisticación en la estructura de precios marca otra diferencia. Mientras Astra y Fable comparten el puntaje 53, el costo promedio por tarea del índice es de 3,26 dólares para la primera y 7,63 para la segunda. Los sistemas de caché, donde Fable cobra 0,25 dólares por millón frente a 1 dólar de Astra, pueden cambiar completamente la ecuación en pipelines de trabajo repetitivos. “Contar hay que hacerlo en tu propio registro de llamadas, no en la etiqueta promocional”, advierten los expertos.
El mensaje final es claro: ya no existe un modelo único para todos los casos. La elección depende del dominio específico, el presupuesto y la infraestructura técnica. Los laboratorios chinos han alcanzado la madurez suficiente para competir de igual a igual en segmentos clave, mientras mantienen ventajas de costo que los hacen irresistibles para implementaciones a escala. La era del monopolio occidental en IA de vanguardia ha terminado.