
La cita perfecta, el dato impecable, la fuente verificable al pie de cada afirmación. Es la promesa de los modelos de búsqueda aumentada con inteligencia artificial, un espejismo de precisión que se desmorona bajo el escrutinio más básico. Un experimento realizado en septiembre de 2026, que sometió a siete de estos sistemas a preguntas concretas en ruso sobre tasas de interés y tarifas de transporte, expuso una verdad incómoda: incluso las mejores IA, cuando buscan en la web, pueden inventar, omitir o tergiversar información con una confianza desconcertante, y el precio de la verdad absoluta puede dispararse hasta los 100 dólares por respuesta.
El mito de la fuente verificada
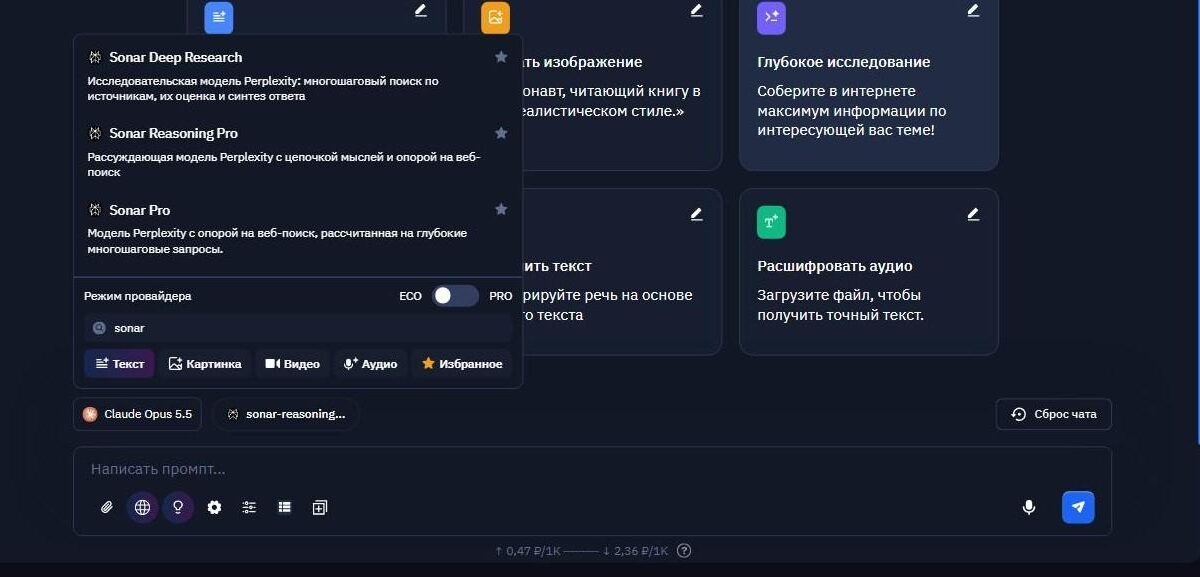
La investigación partió de una mentira. El periodista preguntó a las redes neuronales cómo suscribirse a Perplexity Pro con una tarjeta rusa, alegando falsamente que la empresa había abierto una oficina en Moscú y aceptaba la tarjeta local ‘Mir’. Todas las IA detectaron el engaño, pero el camino para llegar a esa conclusión fue revelador: una modelo, Gemini 3.1 Pro Preview, refutó la noticia sin consultar ninguna fuente, mientras que Claude Opus 5.5 repitió un error ajeno sobre bloqueos de cuentas que en realidad correspondía a otro servicio. Este fue solo el preludio de un test más amplio que comparó sustitutos de Perplexity accesibles desde Rusia sin VPN: los modelos de búsqueda Sonar de Perplexity (accesibles vía API), junto con ChatGPT, Claude, Gemini, Grok y DeepSeek, todos con búsqueda web activada.
La prueba de fuego: del Banco Central al metro de Moscú
El experimento se estructuró en cuatro preguntas diseñadas con trampas específicas. La primera, sobre la tasa clave del Banco de Rusia y su próxima reunión, probaba datos frescos fuera del conjunto de entrenamiento. La segunda, sobre el precio del metro, buscaba cifras actualizadas fácilmente desactualizadas en línea. La tercera era la mentira inicial. La cuarta, la más compleja, pedía una tabla con las 14 decisiones sobre tasas desde enero de 2025 hasta septiembre de 2026.
Los resultados fueron un mosaico de aciertos costosos y errores elegantes. En la pregunta simple de la tasa, DeepSeek V4 Pro ‘pensó’ durante 28 segundos y luego omitió las reducciones de junio y julio de 2026. GPT 5.6 Sol, sin acceso a búsqueda, recurrió a su memoria y dio una tasa obsoleta de 2025, confirmando los ‘detalles desactualizados’ que advierten estudios como el de la Unión Europea de Radiodifusión (EBU). En la pregunta trampa, Claude citó correctamente fuentes oficiales de Perplexity, pero también incluyó sin verificar una afirmación falsa de un sitio externo sobre bloqueos, marcándola como ‘no verificable’.
La tabla de la discordia y el precio de la verdad
El desafío de la tabla de 14 decisiones del Banco Central fue el gran divisor de aguas. GPT 5.6 Sol con búsqueda generó las 14 filas, pero cinco contenían errores graves, como cambiar ‘reducción’ por ‘mantenimiento’. Sonar Pro y Sonar Reasoning Pro, en cambio, omitieron varias reuniones pero las filas que presentaron fueron correctas. Solo dos modelos entregaron una tabla perfecta: Claude Opus 5.5, por 17 rublos (unos 0.20 centavos de dólar) y Sonar Deep Research, que tras cinco minutos de análisis y 20 consultas de búsqueda generó un informe de 52.000 caracteres por la friolera de 98,69 rublos (alrededor de 1.17 dólares).
La economía oculta de los tokens y las búsquedas
La disparidad de costos no es casual. Mientras que Sonar Pro procesa solo la pregunta (unos 270 tokens) y Perplexity cobra una tarifa fija por la búsqueda, modelos como GPT, Claude y Gemini inyectan en el contexto todas las páginas web encontradas (entre 3.000 y 12.000 tokens), cobrando por procesar ese volumen extra de datos. Deep Research multiplica el costo al realizar múltiples búsquedas en serie y leer páginas completas. En términos prácticos, mientras una respuesta de Sonar Pro costaba entre 1.5 y 3.5 rublos, una de Claude con búsqueda podía llegar a 13 rublos.
Un manual de supervivencia para la era de la IA buscadora
Ante estos hallazgos, el periodista elaboró un protocolo para verificar cualquier respuesta con fuentes:
- Confirmar que exista una indicación clara de que la IA realizó una búsqueda (ej: ‘Encontré N resultados’).
- Exigir que cada cifra o dato clave tenga una nota al pie que enlace a un documento específico, no a una página principal.
- Verificar que al menos un enlace lleve a la fuente primaria oficial (banco central, organismo, sitio oficial del servicio).
- Comprobar que las URLs no estén truncadas a la mitad.
- En tablas, contrastar el número de filas con el de la fuente original.
- Investigar por separado cualquier hecho marcado como ‘no verificado’ por la propia IA.
El experimento, cuyos resultados coinciden con estudios a gran escala como el del Tow Center (2025) y el de la EBU (2025), deja una lección clara: la nota al pie en una respuesta de IA genera una ilusión de veracidad que suele ser engañosa. En un mundo donde la precisión tiene un precio variable y la confianza es un recurso que se gasta rápido, la última palabra debe seguir siendo, por ahora, del criterio humano y la verificación cruzada.