
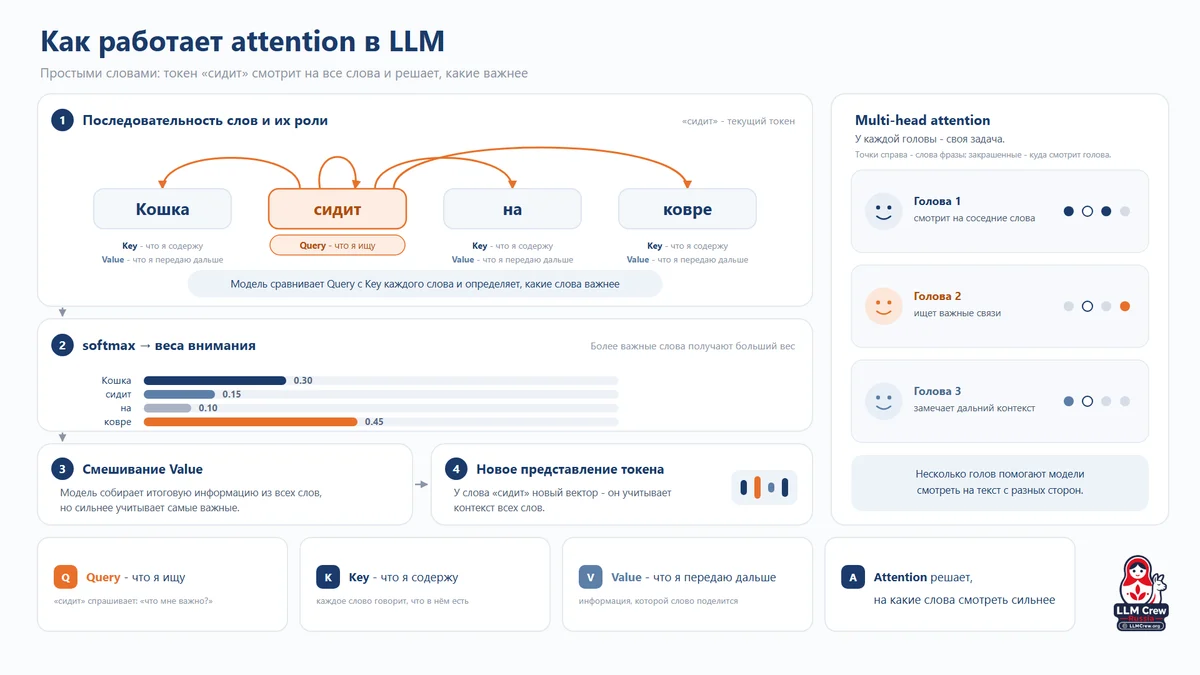
El mecanismo de atención —el corazón latente de todo Transformer— dejó de ser una operación monolítica para convertirse en un campo de batalla donde cada FLOP cuenta. En 2026, los equipos de DeepSeek, Kimi, MiniMax y Qwen no compiten por inventar una nueva fórmula matemática, sino por combinar niveles de optimización: cómo se representa el KV cache, qué partes del contexto se leen realmente y cómo se ejecuta todo eso sobre el silicio disponible. La conclusión es clara: gana el stack que mantiene calidad de retrieval y razonamiento sin explotar el ancho de banda de memoria.
Del MHA clásico a MLA: la guerra por el KV cache
El Multi Head Attention (MHA) original daba a cada cabeza sus propias proyecciones Q, K y V. Era expresivo, pero carísimo en memoria. Multi Query Attention (MQA) redujo el cache compartiendo una sola pareja K/V entre todas las cabezas query, con pérdida de calidad. Grouped Query Attention (GQA) emergió como el compromiso maduro: agrupar cabezas query bajo cabezas KV compartidas, logrando calidad cercana al MHA con buena parte del ahorro de MQA. Hoy, GQA + un kernel de exact attention optimizado sigue siendo la base conservadora y production-proven de la industria.
Pero DeepSeek fue más lejos con Multi Head Latent Attention (MLA), introducido en DeepSeek V2. En lugar de almacenar K y V completos, el modelo guarda un compacto latente del que se reconstruyen las proyecciones necesarias. Según el reporte de DeepSeek, esto redujo el KV cache un 93,3% respecto a su arquitectura anterior y multiplicó el throughput de generación hasta 5,76 veces. El precio: proyecciones más complejas, kernels especiales y sensibilidad al balance de hardware. En escenarios bandwidth-limited, el intercambio vale la pena; en otro GPU, no tanto.
Sparsity y compresión: DeepSeek-V4 da el salto
El siguiente paso lo da DeepSeek-V4 con dos mecanismos: Compressed Sparse Attention (CSA) y Heavily Compressed Attention (HCA). CSA primero comprime la historia agrupando tokens vecinos y luego un indexer selecciona solo las partes relevantes para cada query. HCA comprime mucho más agresivamente —128 tokens en una sola representación— y permite dense attention sobre toda la historia comprimida sin indexer, complementado con una sliding window local para preservar detalle reciente.
Los números son contundentes: con contexto de 1M de tokens, DeepSeek-V4-Pro requiere aproximadamente 27% de los FLOPs de inferencia single-token y 10% del KV cache respecto a DeepSeek-V3.2. El principio de diseño es la novedad real: compresión y sparsity dejan de ser alternativas y empiezan a trabajar juntas.
MiniMax, por su parte, desarrolló MiniMax Sparse Attention (MSA) sobre GQA. Un indexer divide el contexto en bloques de 128 tokens y selecciona top-16 bloques por cada grupo GQA, de modo que la rama principal de atención trabaja con apenas 2048 KV tokens sin importar la longitud total. En un experimento controlado con una modelo MoE de 109B y contexto de 1M, reportaron 28,4× menos cómputo de atención, 14,2× de aceleración en prefill y 7,6× en decode sobre H800. Eso sí: MSA no reduce el KV cache, solo evita procesarlo entero cada vez.
Kimi Linear: la apuesta recurrente
Kimi Linear da un paso más radical con Kimi Delta Attention (KDA), un híbrido de capas lineales/recurrentes y MLA. En lugar de almacenar K y V de cada token, comprime la historia en un estado recurrente de tamaño fijo. Los autores reportan que un modelo de 48B de parámetros (3B activos) supera a la variante con full MLA en iguales condiciones de entrenamiento, con KV cache reducido al 75% y velocidad de generación hasta 6× mayor en contexto de 1M. La limitación: la pérdida de acceso exacto al pasado y la falta de confirmación independiente a gran escala.
FlashAttention y el cuello de botella del hardware
Toda esta arquitectura se ejecuta sobre GPU, y ahí entra FlashAttention. La idea central no cambia la matemática de la atención, sino cómo se mueven los datos entre la memoria HBM y los bloques de cómputo. FlashAttention procesa Q, K y V en bloques pequeños cargados en memoria rápida del GPU, calculando softmax de forma incremental sin materializar la matriz completa de scores. FA3 se optimizó para Hopper; FA4 apunta a Blackwell (B200/GB200), alcanzando hasta 1613 TFLOPS en BF16 —71% del pico teórico— y aceleraciones de hasta 2,7× respecto a Triton. Pero como advierte el análisis: no siempre gana la versión más nueva. En vLLM o SGLang, cuDNN SDPA, FlashInfer o kernels especializados para MLA o sparse pueden ser más rápidos según la configuración concreta.
El gran trend de 2026 no es buscar un único mecanismo de atención ganador, sino apilar niveles: reducir el estado por token, comprimir la historia, seleccionar solo lo relevante y exprimir el kernel para el hardware específico. Y en ese ecosistema, el open source de Oriente juega un rol clave: DeepSeek publica arquitectura, MiniMax libera kernels, Kimi experimenta con híbridos. Las ideas circulan, se recombinan y se testean en escenarios reales. La atención ya no es una fórmula: es un stack.