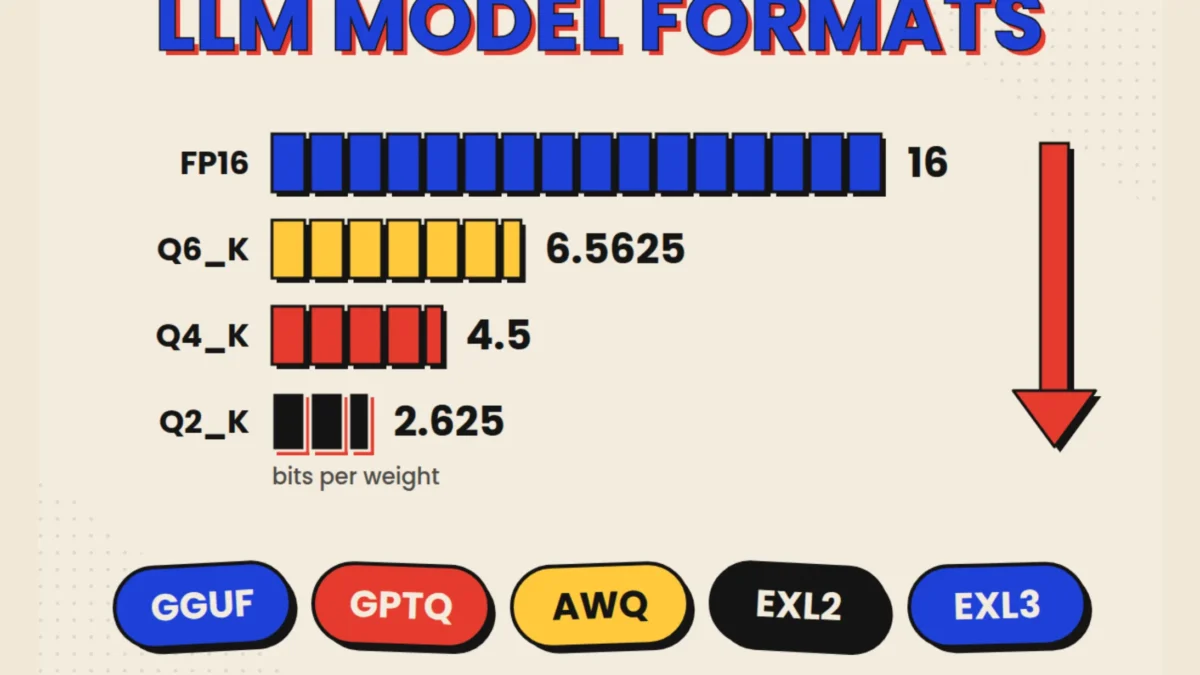
Si alguna vez te sentiste abrumado buscando un modelo de lenguaje y te encontraste con una sopa de letras como GGUF, GPTQ, AWQ o EXL2, no estás solo. La confusión es la norma, pero tiene solución. El primer error, y el más común, es mezclar dos conceptos totalmente distintos: el contenedor (cómo se guardan los pesos en el disco) y el método de cuantización (cómo se comprimen esos pesos para que ocupen menos). Pensar que ‘GGUF’ es un tipo de cuantización es como creer que un ZIP es un formato de imagen. Esta distinción es la clave para dejar de navegar a ciegas.
GGUF: el rey indiscutido de la computación local
Creado por Georgi Gerganov para su proyecto llama.cpp, el formato GGUF es mucho más que un simple contenedor. Es un paquete todo-en-uno que lleva no solo los pesos cuantizados, sino también el tokenizador, las plantillas de chat e incluso metadatos extensibles. Su gran ventaja es que está optimizado para funcionar con memoria compartida (mmap), lo que permite cargar modelos más grandes que la RAM de tu sistema. Si usás CPU, una Mac con Apple Silicon o hacés inferencia mixta con CPU+GPU, GGUF es tu estándar de facto. Los tipos de cuantización como Q4_K_M o Q6_K definen cuántos bits por peso se usan, equilibrando calidad y tamaño. Para la mayoría, empezar con Q4_K_M y subir a Q5_K_M si sobra memoria es la regla de oro.
GPTQ y AWQ: los caballos de batalla para servidores GPU
Del otro lado del ring, para entornos de servidor con GPUs NVIDIA, los métodos GPTQ y AWQ reinan. Ambos son métodos de cuantización post-entrenamiento que reducen los modelos a 4 bits, pero con filosofías distintas. GPTQ, nacido en ETH Zurich, usa información de segundo orden (Hessiana) para ajustar los pesos de manera inteligente, minimizando el error. AWQ, del MIT, adopta un enfoque más astuto: identifica el 1% de los pesos más ‘importantes’ observando las activaciones, y los escala para protegerlos, manteniendo un formato uniforme y rápido para el hardware. En la práctica, AWQ suele ser más rápido de calibrar (unos 10 minutos para un modelo de 8B en una A100, frente a los 20 de GPTQ), pero la elección entre uno y otro hoy se reduce a usar la herramienta moderna: `llm-compressor` de vLLM, que ha reemplazado a las bibliotecas AutoGPTQ y AutoAWQ, ahora obsoletas.
EXL2/EXL3 y más allá: la vanguardia para el usuario exigente
Para el usuario con una GPU de consumo que busca el máximo rendimiento en tokens por segundo, el ecosistema ExLlama es la respuesta. EXL2, y su sucesor EXL3, son un combo de método de cuantización y diseño de almacenamiento optimizado para una sola biblioteca de inferencia. La magia de EXL3, basada en la investigación QTIP de Cornell, es la cuantización de tasa mixta: permite mezclar diferentes niveles de bits (de 2 a 8) dentro de un mismo modelo e incluso dentro de una misma capa, logrando ajustes finísimos como 4.65 bits por peso. El resultado son modelos como el Llama-3.1-70B coherentes con apenas 1.6 bits por peso, cabiendo en menos de 16 GB de VRAM. Es la opción preferida para una inferencia local ultrarrápida en una RTX 4090.
Entonces, ¿qué elegir? El mapa es claro: GGUF para CPU, Mac o modelos que no entran en tu VRAM; GPTQ/AWQ vía vLLM para servir a múltiples usuarios en GPUs de servidor; EXL3 (o EXL2 para configs más viejas) para exprimir al máximo una GPU de consumo; y bitsandbytes NF4 si tu plan es hacer fine-tuning con QLoRA en un presupuesto ajustado. La era de descargar el archivo más pequeño y rezar para que funcione terminó. Ahora, la elección es estratégica y define tu flujo de trabajo.