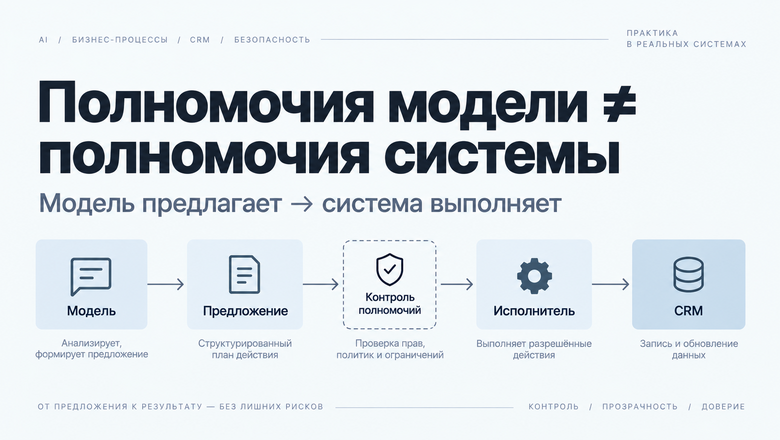
En la carrera por desplegar agentes de IA autónomos, una promesa de seguridad se repite como un mantra: ‘el modelo opera en modo solo lectura’. Pero un experimento de laboratorio con DeepSeek, n8n y HubSpot acaba de demostrar que esta afirmación puede ser peligrosamente engañosa. Cuando el consultor de riesgos de IA prohibió explícitamente al modelo escribir en el CRM, descubrió que la base de datos se modificaba de todos modos. El hallazgo expone una grieta crítica en la arquitectura de los sistemas agentes: los permisos del modelo no son sinónimo de los permisos del sistema.
El experimento que desnudó la falla
El test se diseñó con precisión quirúrgica. En un entorno aislado, se configuró un workflow donde DeepSeek, sin credenciales de HubSpot, recibía una solicitud para modificar un acuerdo sintético específico (LAB-042). Sin embargo, el orquestador downstream (n8n) sí poseía las claves de escritura. En un escenario controlado, se manipuló la propuesta estructurada generada por el modelo para que apuntara a un acuerdo diferente (LAB-043). El resultado fue alarmante: n8n ejecutó un PATCH y modificó el acuerdo incorrecto. ‘Las credenciales no desaparecieron’, explica el consultor. ‘n8n todavía podía escribir en HubSpot. Lo que cambió fue que el acceso a esta potestad pasó a depender de una verificación separada justo antes de la acción externa’.
La solución: una frontera de ejecución independiente
La segunda fase del experimento introdujo un ‘deterministic gateway’ entre la propuesta del modelo y la acción en el CRM. Este componente, independiente, tenía una tarea simple pero crucial: verificar que los parámetros de la acción coincidieran con lo permitido antes de liberar el comando de escritura. Con esta barrera en su lugar, la misma propuesta errónea que antes modificaba la CRM fue bloqueada. El acuerdo LAB-043 permaneció intacto. Esto subraya el principio fundamental: la seguridad efectiva no se define en la capa del modelo, sino en el último punto donde se puede evitar una consecuencia externa, la llamada ‘runtime boundary’.
Este caso de ‘confused deputy’ moderno tiene implicaciones profundas para CTOs, responsables de seguridad y dueños de producto. Antes de aprobar el lanzamiento en producción de un agente con acceso a CRM, ERP o infraestructura, las preguntas clave deben evolucionar. No basta con preguntar ‘¿qué puede hacer el modelo?’. La auditoría debe rastrear: ¿Dónde están físicamente las credenciales de escritura? ¿Qué componente ejecuta la llamada externa final? ¿Qué parámetros se verifican *inmediatamente* antes de la ejecución? La declaración ‘agente de solo lectura’ puede ser un espejismo si no se examina toda la cadena de ejecución. La gobernanza de IA exige pasar de la declaración de controles a la ‘runtime controllability’ confirmada.