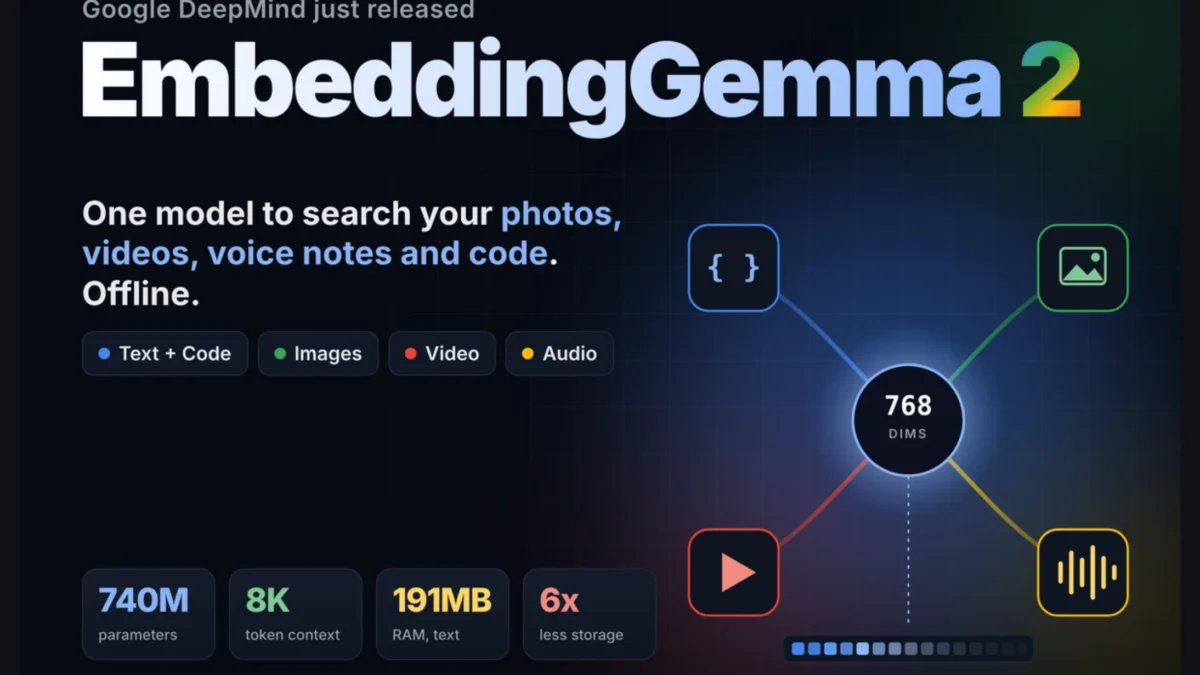
Google DeepMind acaba de publicar EmbeddingGemma 2, un modelo de embeddings multimodal de 740 millones de parámetros construido sobre la arquitectura Gemma 4. La propuesta es disruptiva: unifica texto, código, imágenes, video y audio en un único espacio vectorial de 768 dimensiones. Para los desarrolladores que trabajamos con flujos de generación aumentada por recuperación (RAG), esto significa que una consulta de texto puede recuperar directamente un fragmento de video o una nota de voz, sin salir del dispositivo y garantizando privacidad total.
Modularidad y eficiencia on-device
El diseño es completamente modular. Podemos cargar solo lo que el proyecto necesita: 270M para texto, 440M para sumar visión, 570M para audio, o los 740M completos. Lo más interesante es que todas las configuraciones comparten el mismo espacio vectorial, lo que permite que una query embebida con el modelo de texto puro coincida con documentos procesados por el modelo completo. Con una ventana de contexto de 8.192 tokens, entra material equivalente a 29 imágenes o 5,5 minutos de audio.
La optimización para hardware de borde es notable. Gracias al entrenamiento consciente de la cuantización (INT4 e INT8), el modelo completo consume apenas 567 MB de RAM activa en un Pixel 11 Pro, mientras que la versión de texto se ajusta a 191 MB. Además, implementa Matryoshka Representation Learning (MRL), lo que nos permite truncar los vectores a 512, 256 o 128 dimensiones para ahorrar hasta 6x en almacenamiento, con una pérdida mínima de precisión en cargas de trabajo de texto.
Benchmarks e integración en el pipeline
En las métricas, el modelo marca la delantera en la categoría sub-1B. La recuperación de código en MTEB Code v1 saltó de 68.76 a 78.68, una mejora del 14%. Si bien modelos más pesados como Qwen3-VL-Embedding-2B superan algunas métricas visuales, carecen de soporte de audio y triplican el tamaño. La ventaja competitiva de EmbeddingGemma 2 es su licencia Apache 2.0 y su foco en la productividad local.
La implementación es directa. Los pesos ya están disponibles en Hugging Face y es compatible con sentence-transformers, Ollama y llama.cpp. Para quienes usamos bases de datos vectoriales como Qdrant, la integración es transparente. Incluso podemos correrlo localmente con un simple comando en la terminal: ollama pull embeddinggemma-2. La arquitectura interna se divide de la siguiente manera:
- Texto y código: 270M parámetros (130M transformer + 140M embedder).
- Visión: Encoder de 170M, opcional.
- Audio: Encoder de 300M, opcional.
En definitiva, EmbeddingGemma 2 se posiciona como la herramienta ideal para aplicaciones de búsqueda local, clasificación y RAG con privacidad. Es una solución madura, lista para producción y que redefine lo que podemos esperar de la inteligencia artificial en el borde.